Нестабильные тесты в Gradle
Нестабильные тесты — это тесты, которые дают разные результаты (проходят или падают) при многократном запуске с одним и тем же кодом. Они подрывают доверие к набору тестов и отнимают время разработчиков на расследование ложных сбоев. Tuist автоматически обнаруживает нестабильные тесты и помогает отслеживать их со временем.
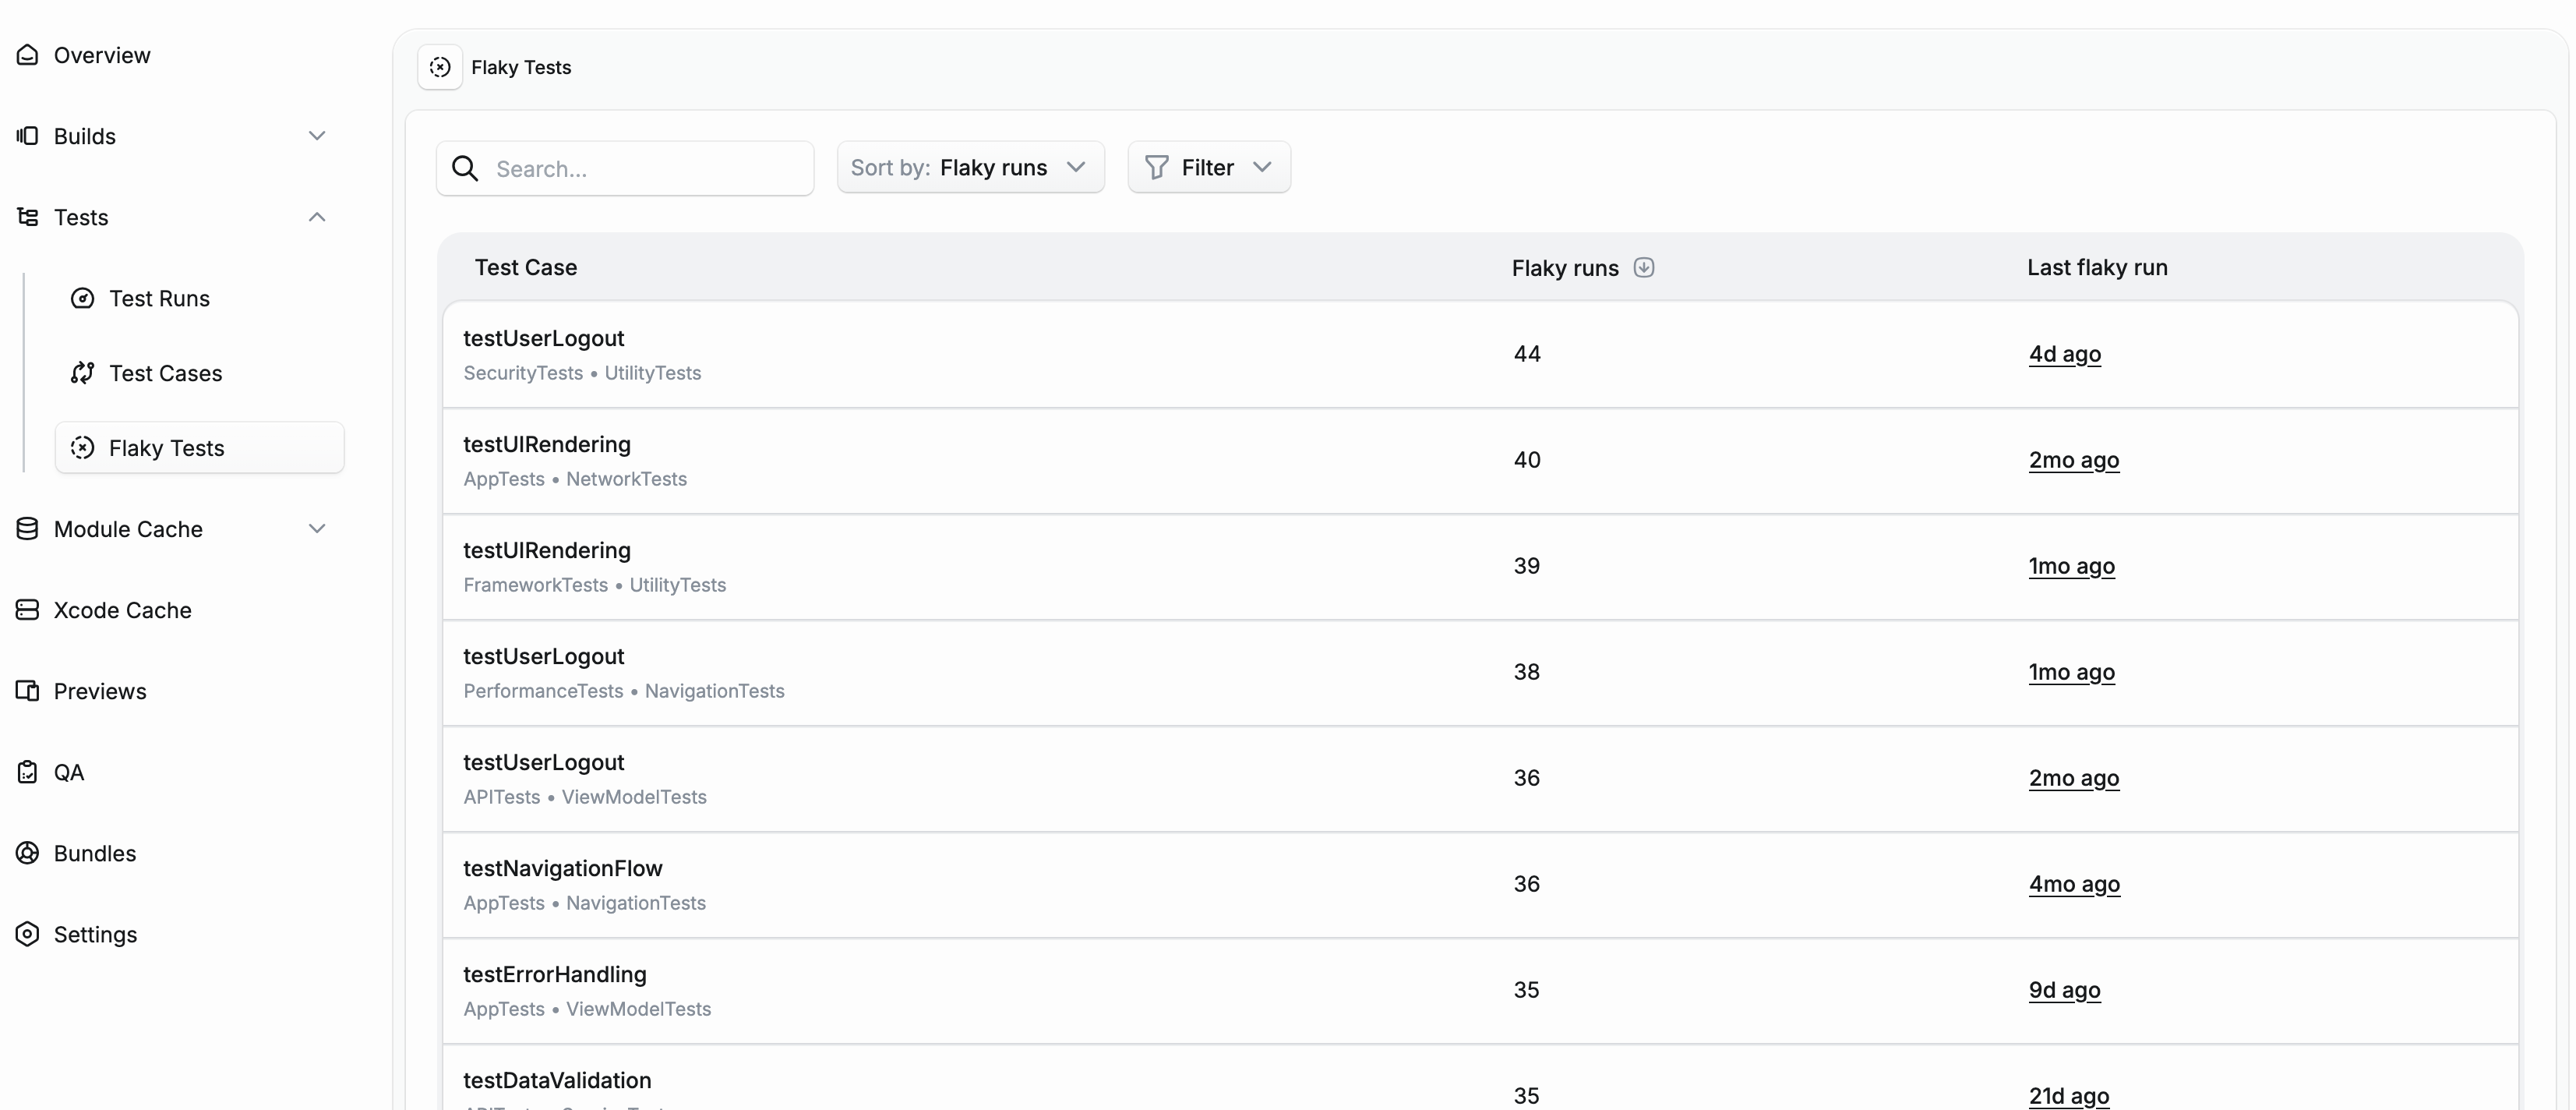
Как работает обнаружение нестабильности#
Tuist обнаруживает нестабильные тесты двумя способами:
Повторные запуски тестов#
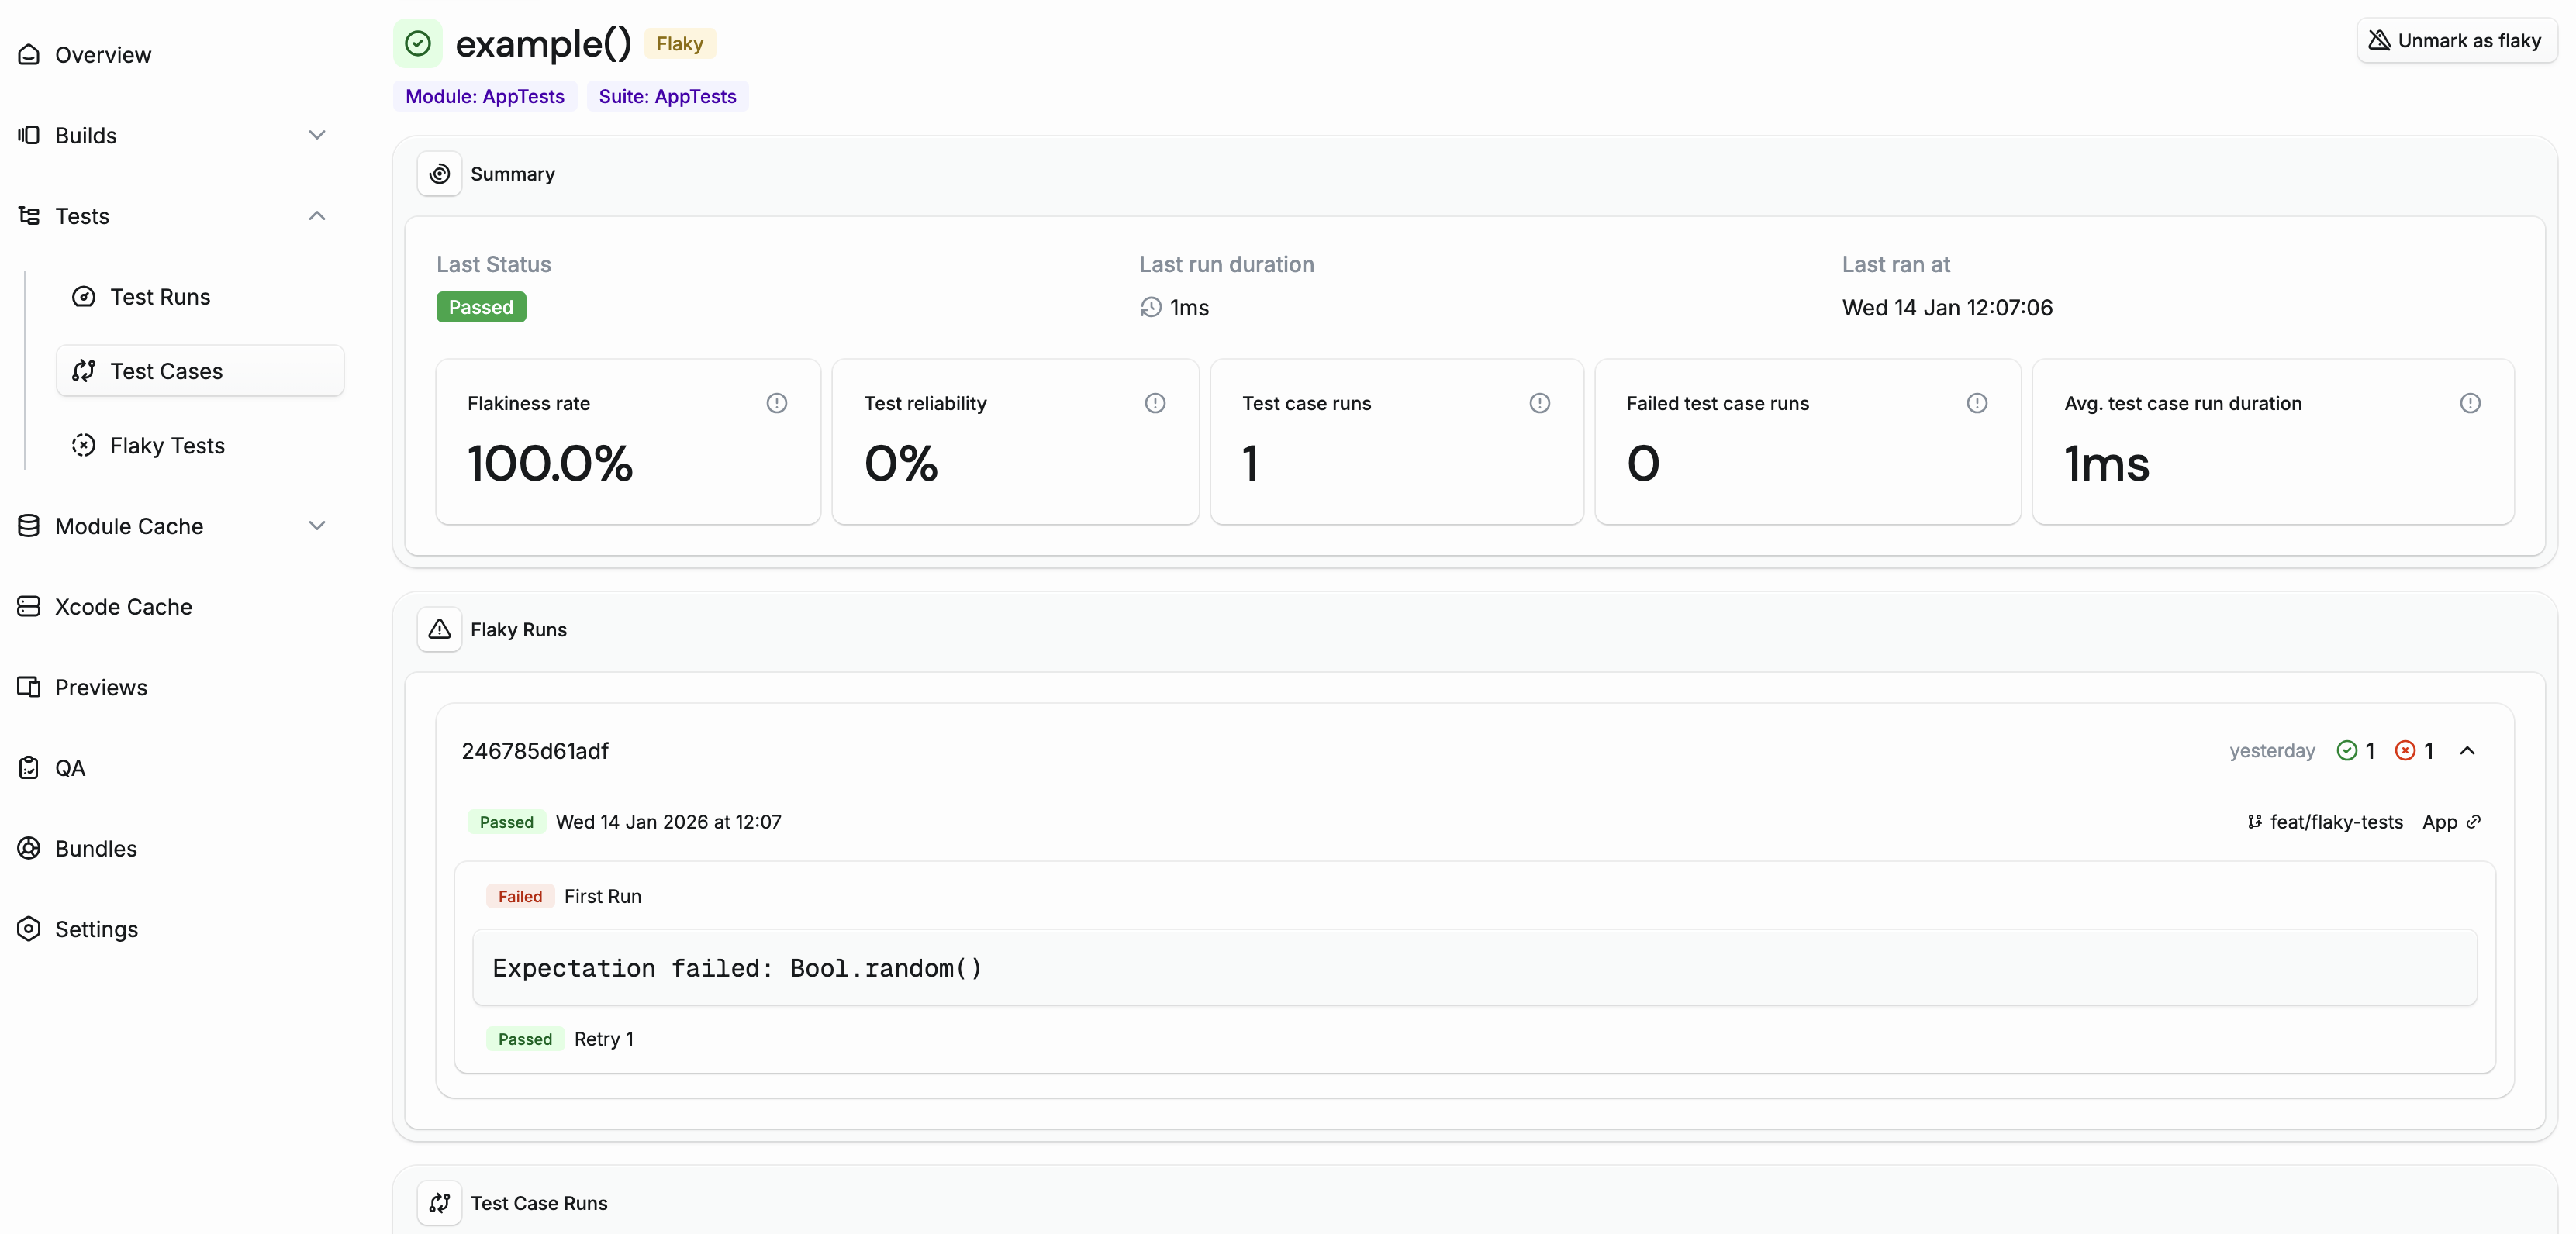
Когда вы запускаете тесты с функцией повторных попыток, Tuist анализирует результаты каждой попытки. Если тест падает в некоторых попытках, но проходит в других, он помечается как нестабильный.
Вы можете использовать плагин Test Retry или аналогичный механизм для повторного запуска упавших тестов. Tuist обнаружит тесты, которые проходят в одних попытках, но падают в других.
Добавьте плагин в ваш build.gradle.kts:
plugins {
    id("org.gradle.test-retry") version "1.6.2"
}

tasks.test {
    retry {
        maxRetries = 3
        maxFailures = 5
        failOnPassedAfterRetry = false
    }
}
Обнаружение между запусками#
Даже без повторных запусков тестов Tuist может обнаруживать нестабильные тесты, сравнивая результаты разных запусков CI для одного и того же коммита и одного и того же проекта Gradle. Если тест проходит в одном запуске CI, но падает в другом запуске для того же коммита и проекта, оба запуска помечаются как нестабильные.
Проект Gradle является частью ключа сравнения, потому что один и тот же тест может вести себя детерминированно по-разному в разных проектах — например, общий тестовый класс, скомпилированный с разными зависимостями или запущенный на другом фикстуре модуля. Два запуска одного и того же коммита на разных проектах Gradle рассматриваются как отдельные варианты выполнения и не будут помечать друг друга как нестабильные.
Это особенно полезно для выявления нестабильных тестов, которые не падают достаточно постоянно, чтобы быть пойманными повторными запусками, но всё ещё вызывают периодические сбои CI.
Управление нестабильными тестами#
Автоматическая очистка#
Обнаружение и очистка выполняются через автоматическое оповещение в проекте. Каждый проект получает автоматизацию «Обнаружение нестабильных тестов» по умолчанию, чей триггер помечает тест как нестабильный, а восстановление снимает флаг, когда тест проходит настроенное окно восстановления (по умолчанию 14 дней) без повторного срабатывания. Отредактируйте её в разделе Настройки → Автоматизации, чтобы изменить окно восстановления, заменить действия восстановления (например, также снять карантин) или полностью отключить восстановление, чтобы тесты оставались помеченными как нестабильные, пока вы не очистите их вручную.
Ручное управление#
Вы также можете вручную помечать или снимать пометку нестабильности с тестов на странице деталей тест-кейса. Это полезно, когда:
- Вы хотите подтвердить известный нестабильный тест, работая над исправлением
- Тест был ошибочно помечен из-за проблем с инфраструктурой
Карантин нестабильных тестов#
Карантин изолирует нестабильный тест, чтобы он не блокировал CI, пока вы его исправляете. По умолчанию это ручное действие — вы помещаете в карантин, снимаете с карантина и переключаете режимы на странице деталей тест-кейса в дашборде — но вы также можете подключить это к автоматическому оповещению в разделе Настройки → Автоматизации, чтобы тест автоматически игнорировался (или пропускался) при превышении порога нестабильности и снимался с карантина при восстановлении. Каждый переход, ручной или автоматический, записывается в журнал аудита тест-кейса.
По умолчанию восстановление ожидает, пока условие триггера перестанет выполняться, поэтому тест остаётся в карантине, пока его старые нестабильные запуски не выйдут за пределы окна триггера. Чтобы восстановить быстрее, установите Восстанавливать, когда в Нет новых нестабильных запусков: тест восстанавливается, когда окно восстановления (дни или запуски) проходит без нового нестабильного запуска, каждый новый нестабильный запуск перезапускает это ожидание, и после восстановления только новый нестабильный запуск снова помещает его в карантин.
Тест в карантине находится в одном из двух режимов:
- Игнорируются сбои: тест всё ещё запускается, но плагин устанавливает
ignoreFailures = true, и сборка падает повторно только из-за сбоев, не находящихся в карантине. Сбои всё ещё поступают в детектор нестабильных тестов, поэтому вы можете продолжать наблюдать за тестом, не ломая сборку. Выберите этот вариант для теста, который вы активно исследуете. - Пропускается: плагин фильтрует тест через Gradle's
excludeTestsMatching, поэтому он никогда не запускается. Он не produces новых результатов и исчезает с дашборда нестабильных тестов, пока вы не включите его снова. Выберите этот вариант, когда тест сломан, медленный или настолько постоянно нестабилен, что его запуск просто тратит минуты CI.
Почему тесты в карантине могут отображаться как прошедшие#
- Тесты с игнорированием сбоев всё ещё выполняются. Тест с игнорированием сбоев, который падает, записывается как упавший в запуске тест-кейса и помечается как нестабильный — статус отдельного теста не переписывается. Переопределяется общий запуск тестов: если каждый упавший тест-кейс в запуске имеет игнорирование сбоев, запуск в целом сообщается как пройденный, поэтому сбои с игнорированием не ломают CI.
- Пропущенные тесты вообще не запускаются, поэтому дашборд продолжает показывать статус последнего фактического выполнения теста — этот снимок может быть недельной давности.
Включение карантина#
Карантин автоматически включается в CI (когда установлена переменная окружения CI) и отключается для локальных сборок. Плагин получает список тестов в карантине с сервера Tuist перед каждой задачей тестирования; тесты с игнорированием сбоев запускаются нормально, и их сбои маскируются, пропущенные тесты фильтруются.
Вы можете явно управлять этим в вашем settings.gradle.kts:
tuist {
    testQuarantine {
        enabled = true  // or false to disable
    }
}
Когда enabled не установлено, по умолчанию используется автоопределение: включено в CI, отключено локально.
Стресс-тестирование новых тестов#
Шлюз стресс-тестирования повторно запускает тест-кейсы, добавленные вашей веткой, несколько раз каждый в новом процессе, и сообщает о тех, которые оказываются нестабильными. Вы видите новый нестабильный тест в pull request, который его внёс, а не недели спустя.
Тест-кейс считается новым, если он не запускался в CI за последние 90 дней на основной ветке проекта или на коммите, который уже вошёл в неё. При использовании очереди слияния тест-кейс, запущенный очередью, становится известным, когда коммит очереди входит, и остаётся новым, если очередь его сбрасывает. Коммиты сопоставляются через историю Git, которую Tuist собирает в CI.
Включение#
Шлюз по умолчанию выключен. Установите режим:
report: предупреждает о каждом нестабильном тест-кейсе. Запуск всё ещё завершается со своим собственным результатом.enforce: нестабильный тест-кейс приводит к сбою запуска с тем же кодом выхода, что и при обычном сбое теста.
Начните с report на пару недель, чтобы увидеть, что бы заблокировал enforce.
Объявите это в settings.gradle.kts или установите TUIST_TEST_STRESS_NEW_TESTS, чтобы менять режим для каждого этапа CI:
tuist {
    stressNewTests {
        mode = "report" // or "enforce"
    }
}
В отличие от карантина, у шлюза нет настройки по умолчанию с учётом CI. Если mode не установлено, он не запускается нигде.
Сколько раз каждый тест перезапускается#
Это зависит от того, сколько времени занял тест-кейс при первом проходе:
| Первый проход | Повторные запуски |
|---|---|
| До 5 с | 10 |
| До 10 с | 5 |
| До 30 с | 3 |
| До 5 мин | 2 |
| Более 5 мин | Не перезапускается |
Каждый повторный запуск — это вложенная сборка Gradle, отфильтрованная по одному тест-кейсу, поэтому каждый запуск получает свежую JVM для тестов. Проход останавливается после 200 тест-кейсов или 10 минут, в зависимости от того, что наступит раньше, и указывает, какой лимит был достигнут.
Когда шлюз не запускается#
- Первый проход уже завершился с ошибкой. Сначала исправьте эти тесты.
- У проекта нет основной ветки, или в CI на ней ещё ничего не запускалось.
- Более 30% тест-кейсов проекта выглядят как новые. Повторный запуск такого количества займёт больше времени, чем это оправдано. Ожидайте этого на проекте, который только начал отправлять данные в Tuist, или после переименования, которое перемещает много тестов сразу.
Уведомления в Slack#
Получайте мгновенные уведомления, когда тест становится нестабильным, настроив оповещения о нестабильных тестах в вашей интеграции со Slack.
Запрос состояния нестабильных и карантинных тестов#
CLI#
Дерево команд tuist test case предоставляет всю информацию, которую Tuist отслеживает о тест-кейсе:
tuist test case list --flaky                       # only flaky test cases
tuist test case list --quarantined                 # only muted or skipped test cases
tuist test case show <test_case_id>                # detail: flakiness rate, last status, run counts
tuist test case events <test_case_id>              # audit log: marked_flaky, muted, skipped, ...
tuist test case run list <test_case_id>            # run history with status and duration
tuist test case run show <test_case_run_id>        # single run, including failure breakdown
Все эти команды поддерживают --json для скриптов.
REST API#
Те же данные доступны по HTTP — см. эндпоинты тест-кейсов в справочнике API для полного списка маршрутов, фильтров и полей ответа. Чтобы изменить состояние тест-кейса (отметить или снять отметку о нестабильности, игнорировать сбои, пропустить), отправьте PATCH /api/projects/{account_handle}/{project_handle}/tests/test-cases/{test_case_id} с is_flaky или state. То же изменение доступно через tuist test case update и инструмент Model Context Protocol update_test_case.